Um sistema multiagente com experiência de modelo
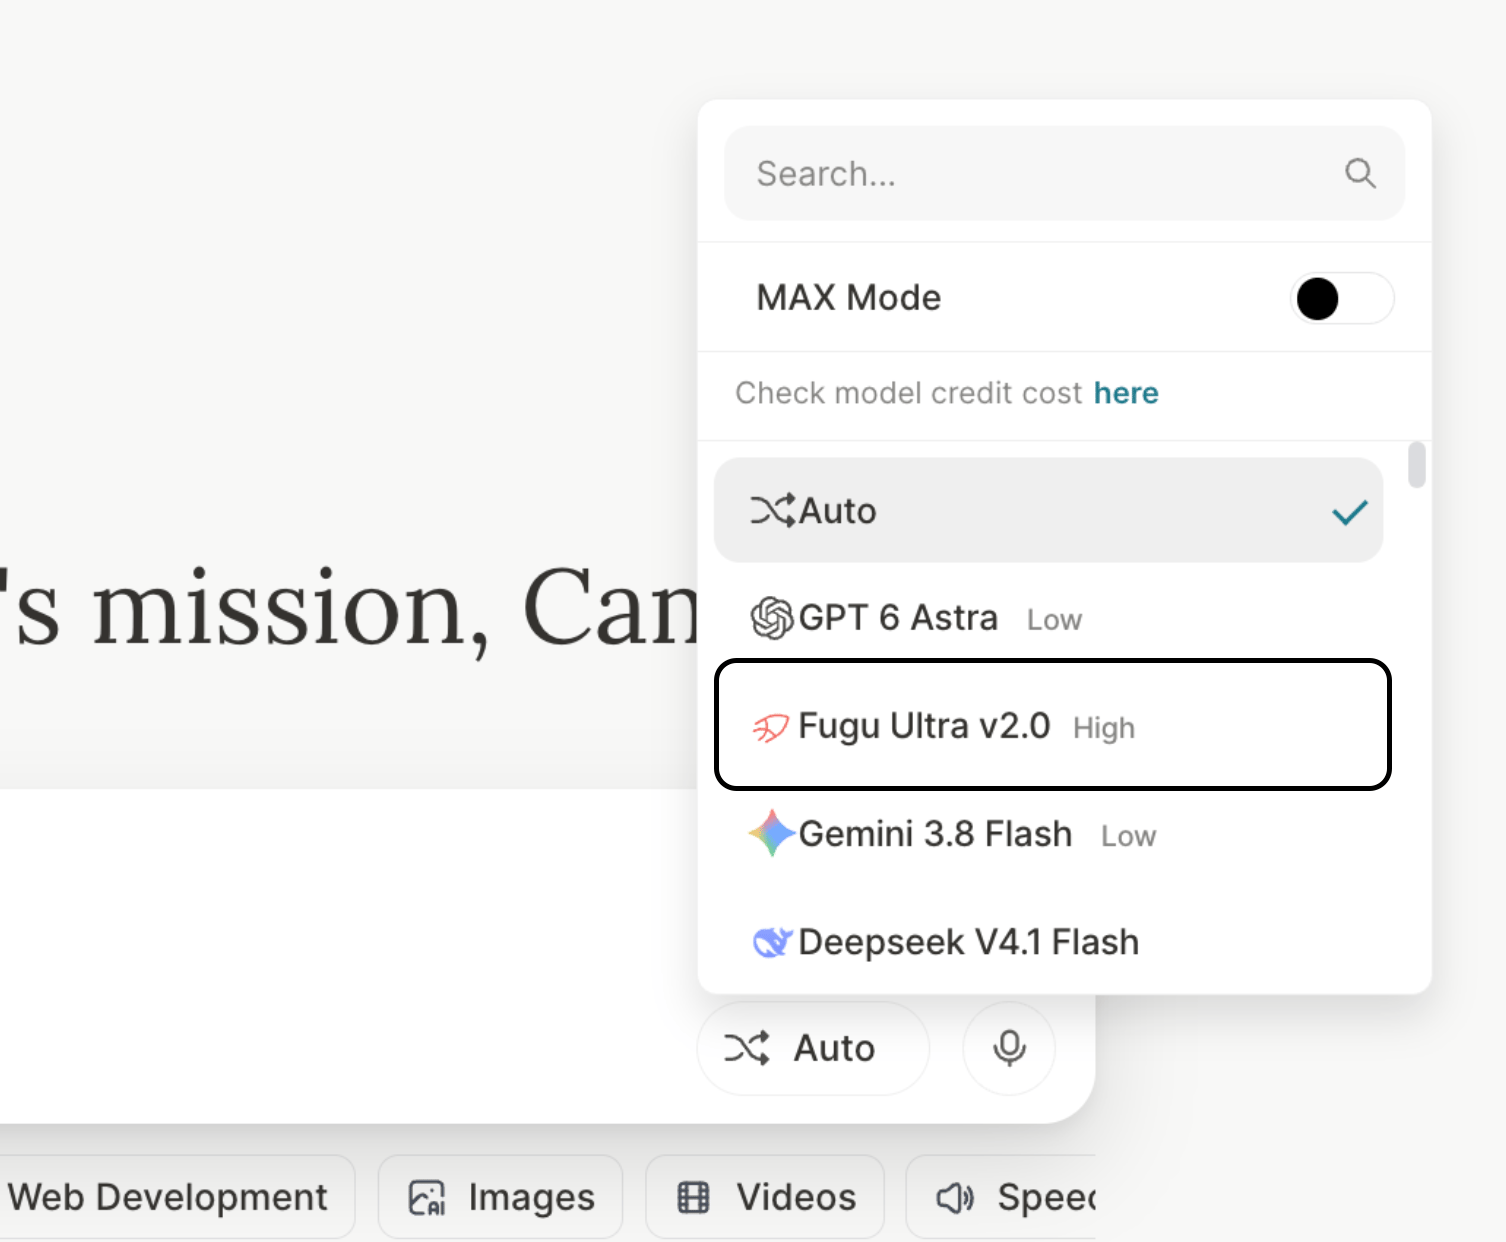
Em vez de depender de um único modelo para executar todo o trabalho, o Fugu Ultra pode acionar de um a três especialistas e coordenar como eles colaboram. Um pode explorar caminhos, outro executar uma parte técnica e outro verificar o resultado. A composição muda conforme a tarefa. Para o usuário, porém, a experiência continua simples: você seleciona Fugu Ultra e descreve o objetivo. A escolha dos especialistas, a divisão do trabalho e a troca de informações acontecem nos bastidores.O pool de especialistas do Fugu Ultra é fixo e o roteamento interno não é exibido. Isso preserva a experiência de um único modelo, mas significa que não é possível escolher ou remover individualmente os modelos participantes.
O que a versão 2.0 prioriza
A versão 2.0 foi desenvolvida para maximizar a qualidade em tarefas difíceis e de alto impacto. Seus principais avanços aparecem em:- reasoning com várias etapas: mantém hipóteses, decisões e verificações ao longo de trabalhos extensos;
- pesquisa autônoma: consulta fontes, relaciona evidências e aprofunda pontos que exigem investigação adicional;
- engenharia de software: navega por repositórios, implementa mudanças, executa testes e revisa o próprio resultado;
- dados visuais e estruturados: interpreta gráficos, documentos, imagens e informações organizadas em diferentes formatos;
- consistência: permanece entre os modelos mais fortes em diferentes categorias de tarefas agênticas, não apenas em um benchmark isolado.
O modelo aceita texto e imagem, oferece contexto de até 1 milhão de tokens e suporta reasoning em níveis altos. Na implementação do provider,
high equilibra desempenho e tempo de resposta, enquanto xhigh aprofunda a análise de problemas complexos.O que os benchmarks mostram
Nos resultados publicados pela Sakana AI, o Fugu Ultra v2.0 obteve a melhor pontuação, isolada ou empatada, em cinco de oito benchmarks e ficou entre os dois primeiros em sete de oito.
No Chartography, a Sakana reporta 48,3 pontos para o Fugu Ultra v2.0, contra 27,3 do Claude Opus 5 e 29,5 do Claude Fable 5. No DeepSWE, o modelo alcança 74,3 pontos.
Esses benchmarks foram publicados pela Sakana AI e dependem da infraestrutura, das ferramentas e dos parâmetros utilizados. De acordo com o fornecedor, Claude Fable 5, Claude Fable 5.1 e GPT-6 Astra não fazem parte do conjunto de modelos compatíveis com o Fugu Ultra v2.0. Valide o modelo em seu próprio fluxo de trabalho antes de substituí-lo por uma configuração de produção.
Onde ele gera mais valor
Uma pesquisa que precisa virar decisão
O trabalho começa com artigos, patentes, relatórios e perguntas ainda abertas. O Fugu Ultra pode distribuir a investigação entre especialistas, confrontar conclusões e entregar uma análise que conecta as fontes, explicita lacunas e recomenda o próximo passo. Resultado esperado: um documento de decisão com evidências rastreáveis, divergências e riscos — não apenas um resumo das fontes.Uma mudança de software que precisa funcionar
Em um repositório grande, encontrar o arquivo certo é apenas o começo. O modelo pode mapear o fluxo, localizar dependências, implementar a alteração, executar testes e revisar o diff antes de concluir. Resultado esperado: código alterado, comportamento validado, testes executados e riscos restantes documentados.Uma análise em que o erro custa caro
Em auditorias, segurança e avaliações técnicas, uma primeira resposta não é suficiente. O Fugu Ultra pode explorar hipóteses concorrentes, procurar evidências contrárias e usar uma etapa de verificação antes de consolidar o resultado. Resultado esperado: conclusões sustentadas por evidências, nível de confiança e pontos que ainda exigem validação humana.Como aplicar na Tess
1
Escolha um trabalho que justifique profundidade
Prefira tarefas com múltiplas fontes, decisões encadeadas ou necessidade de validação. Para reescritas simples e respostas rápidas, um modelo mais leve tende a ser mais eficiente.
2
Entregue contexto e acesso às tools
Inclua arquivos, repositórios, critérios internos e as ferramentas necessárias. Não use 1M de contexto como meta: forneça apenas o material relevante para a execução.
3
Defina o que significa terminar
Informe testes que devem passar, fontes obrigatórias, formato da entrega e condições que precisam ser verificadas.
4
Ajuste a profundidade
Comece em High. Use XHigh quando a tarefa exigir mais investigação, comparação de hipóteses ou ciclos de execução e verificação.
5
Mantenha controle sobre ações críticas
Exija aprovação antes de publicar, excluir, enviar, alterar sistemas produtivos ou executar qualquer ação irreversível.
Três playbooks para começar
1. Reprodução de pesquisa técnica
Entrada: artigo, dados disponíveis, ambiente de execução e resultado esperado.Tools: busca, arquivos, código e terminal.
2. Mudança full-stack com validação
Entrada: repositório, comportamento atual, resultado desejado e padrões do projeto.Tools: código, terminal, testes e documentação técnica.
3. Investigação com fontes conflitantes
Entrada: documentos, planilhas, imagens e critérios de decisão.Tools: busca nos arquivos, web e geração de documentos.
Limitações e boas práticas
- Reserve o Fugu Ultra para tarefas em que a qualidade compense maior latência e custo.
- O modelo pode coordenar várias chamadas internas; trabalhos profundos tendem a consumir mais tokens do que uma resposta direta.
- Não é possível visualizar quais especialistas foram usados em cada solicitação.
- Resultados em pesquisa, segurança, finanças e decisões críticas exigem revisão humana.
- Defina limites claros para tools e confirmação obrigatória para ações irreversíveis.
- Compare o resultado com modelos mais leves antes de padronizar o Fugu Ultra em tarefas cotidianas.