Un sistema multiagente con experiencia de modelo
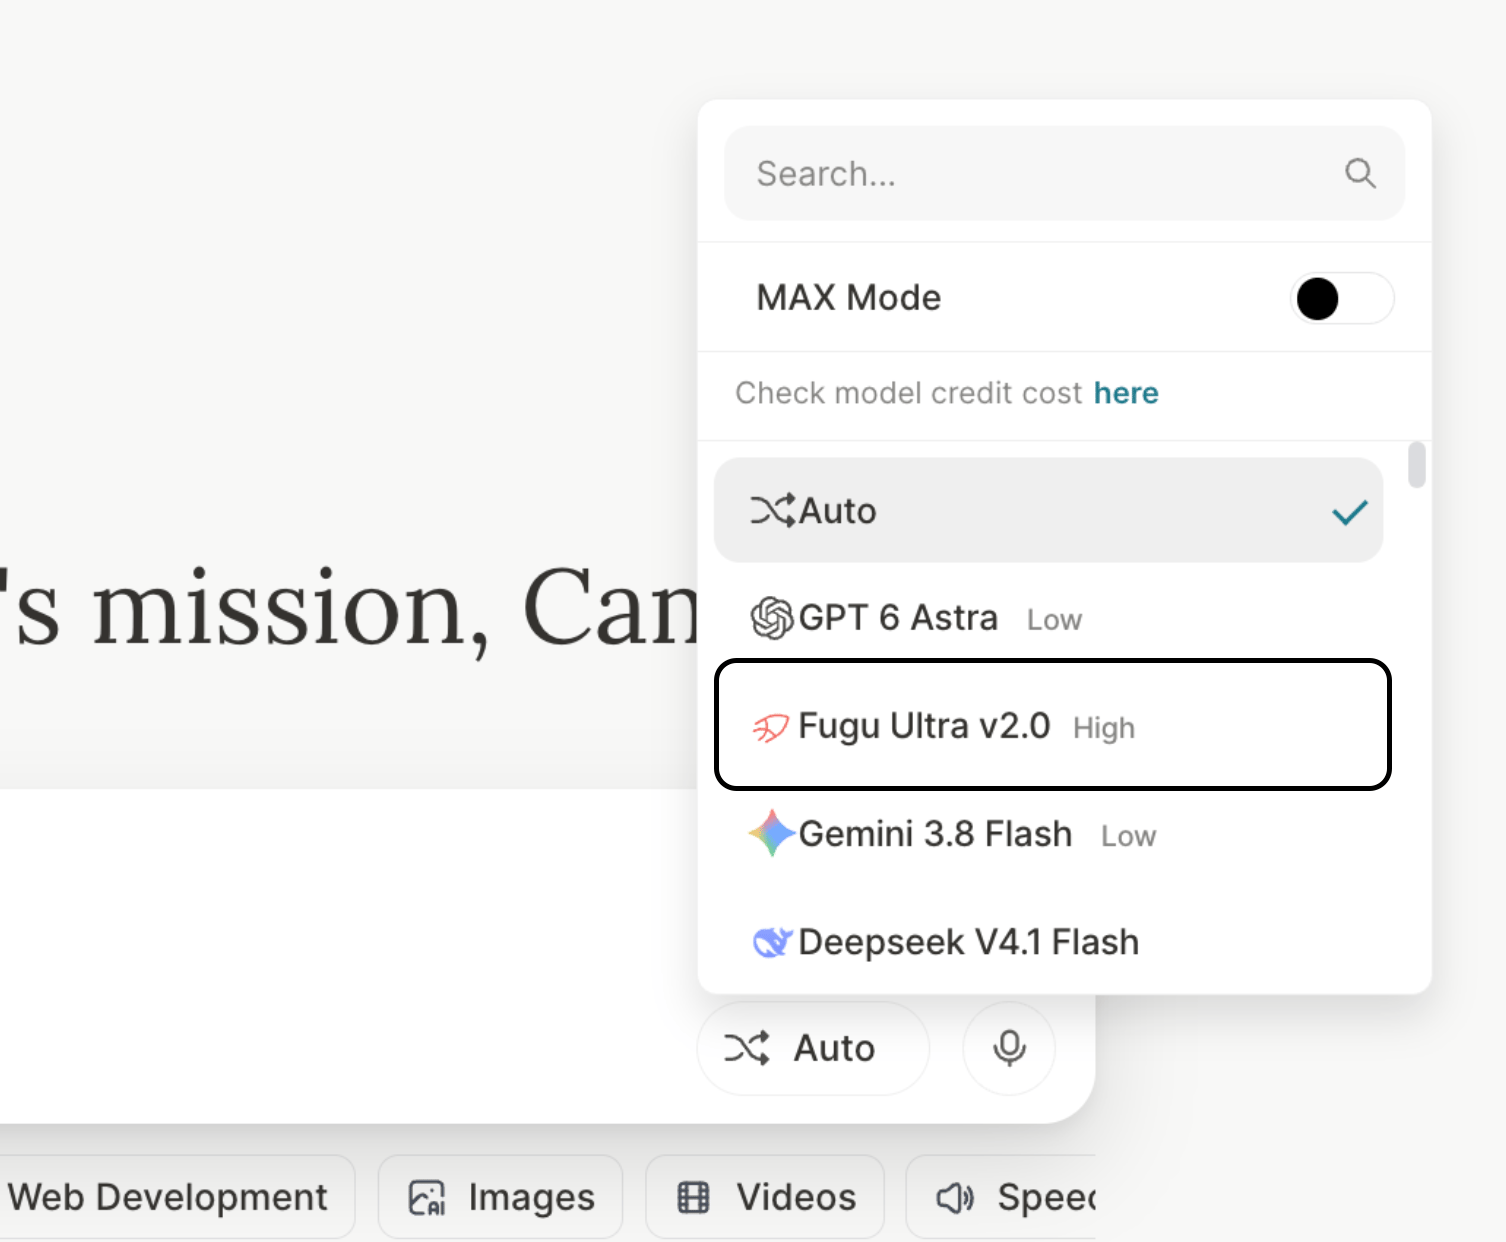
En lugar de depender de un solo modelo para ejecutar todo el trabajo, Fugu Ultra puede activar de uno a tres especialistas y coordinar cómo colaboran. Uno puede explorar caminos, otro ejecutar una etapa técnica y un tercero verificar el resultado. La composición cambia según la tarea. Para el usuario, sin embargo, la experiencia sigue siendo simple: selecciona Fugu Ultra y describe el objetivo. La selección de especialistas, la distribución del trabajo y el intercambio de información ocurren en segundo plano.El pool de especialistas de Fugu Ultra es fijo y su enrutamiento interno no se muestra. Esto conserva la experiencia de un único modelo, pero significa que no se pueden seleccionar ni retirar individualmente los modelos participantes.
Qué prioriza la versión 2.0
La versión 2.0 fue diseñada para maximizar la calidad en tareas difíciles y de alto impacto. Sus principales fortalezas aparecen en:- reasoning de varias etapas: mantiene hipótesis, decisiones y verificaciones a lo largo de trabajos extensos;
- investigación autónoma: consulta fuentes, relaciona evidencias y profundiza en los puntos que requieren análisis adicional;
- ingeniería de software: navega por repositorios, implementa cambios, ejecuta pruebas y revisa su propio resultado;
- datos visuales y estructurados: interpreta gráficos, documentos, imágenes e información organizada en diferentes formatos;
- consistencia: permanece entre los modelos más sólidos en distintas categorías de tareas agénticas, no solo en un benchmark aislado.
El modelo acepta texto e imagen, ofrece hasta 1 millón de tokens de contexto y admite niveles altos de reasoning. En la implementación del provider,
high equilibra rendimiento y tiempo de respuesta, mientras que xhigh profundiza el análisis de problemas complejos.Qué muestran los benchmarks
En los resultados publicados por Sakana AI, Fugu Ultra v2.0 obtuvo la mejor puntuación, en solitario o empatado, en cinco de ocho benchmarks y quedó entre los dos primeros en siete de ocho.
En Chartography, Sakana reporta 48,3 puntos para Fugu Ultra v2.0, frente a 27,3 de Claude Opus 5 y 29,5 de Claude Fable 5. En DeepSWE, el modelo alcanza 74,3 puntos.
Estos benchmarks fueron publicados por Sakana AI y dependen del harness, las tools y los parámetros utilizados. Según el provider, Claude Fable 5, Claude Fable 5.1 y GPT-6 Astra no forman parte del pool de Fugu Ultra v2.0. Valida el modelo en tu propio flujo antes de sustituir una configuración en producción.
Dónde genera más valor
Una investigación que debe convertirse en decisión
El trabajo comienza con artículos, patentes, informes y preguntas abiertas. Fugu Ultra puede distribuir la investigación entre especialistas, cuestionar conclusiones y entregar un análisis que conecta las fuentes, explicita las lagunas y recomienda el siguiente paso. Resultado esperado: un documento de decisión con evidencias rastreables, divergencias y riesgos, no solo un resumen de las fuentes.Un cambio de software que debe funcionar
En un repositorio grande, encontrar el archivo correcto es solo el comienzo. El modelo puede mapear el flujo, localizar dependencias, implementar el cambio, ejecutar pruebas y revisar el diff antes de concluir. Resultado esperado: código modificado, comportamiento validado, pruebas ejecutadas y riesgos restantes documentados.Un análisis donde los errores son costosos
En auditorías, seguridad y evaluaciones técnicas, una primera respuesta no es suficiente. Fugu Ultra puede explorar hipótesis alternativas, buscar evidencias contrarias e incorporar una etapa de verificación antes de consolidar el resultado. Resultado esperado: conclusiones respaldadas por evidencias, un nivel de confianza y puntos que todavía requieren validación humana.Cómo aplicarlo en Tess
1
Elige un trabajo que justifique profundidad
Prefiere tareas con múltiples fuentes, decisiones encadenadas o necesidad de validación. Para reescrituras simples y respuestas rápidas, un modelo más ligero suele ser más eficiente.
2
Proporciona contexto y acceso a las tools
Incluye archivos, repositorios, criterios internos y las herramientas necesarias. No uses 1M de contexto como meta: proporciona solo el material relevante para la ejecución.
3
Define qué significa terminar
Indica las pruebas que deben pasar, las fuentes obligatorias, el formato de entrega y las condiciones que deben verificarse.
4
Ajusta la profundidad
Empieza con High. Usa XHigh cuando la tarea requiera más investigación, comparación de hipótesis o ciclos de ejecución y verificación.
5
Mantén el control sobre las acciones críticas
Exige aprobación antes de publicar, eliminar, enviar, modificar sistemas de producción o realizar cualquier acción irreversible.
Tres playbooks para empezar
1. Reproducir una investigación técnica
Entrada: artículo, datos disponibles, entorno de ejecución y resultado esperado.Tools: búsqueda, archivos, código y terminal.
2. Cambio full-stack con validación
Entrada: repositorio, comportamiento actual, resultado deseado y estándares del proyecto.Tools: código, terminal, pruebas y documentación técnica.
3. Investigación con fuentes contradictorias
Entrada: documentos, hojas de cálculo, imágenes y criterios de decisión.Tools: búsqueda en archivos, web y generación de documentos.
Limitaciones y buenas prácticas
- Reserva Fugu Ultra para tareas en las que la calidad justifique una mayor latencia y costo.
- El modelo puede coordinar varias llamadas internas; los trabajos profundos suelen consumir más tokens que una respuesta directa.
- No es posible ver qué especialistas se utilizaron en cada solicitud.
- Los resultados en investigación, seguridad, finanzas y decisiones críticas requieren revisión humana.
- Define límites claros para las tools y exige confirmación para las acciones irreversibles.
- Compara los resultados con modelos más ligeros antes de estandarizar Fugu Ultra para tareas cotidianas.